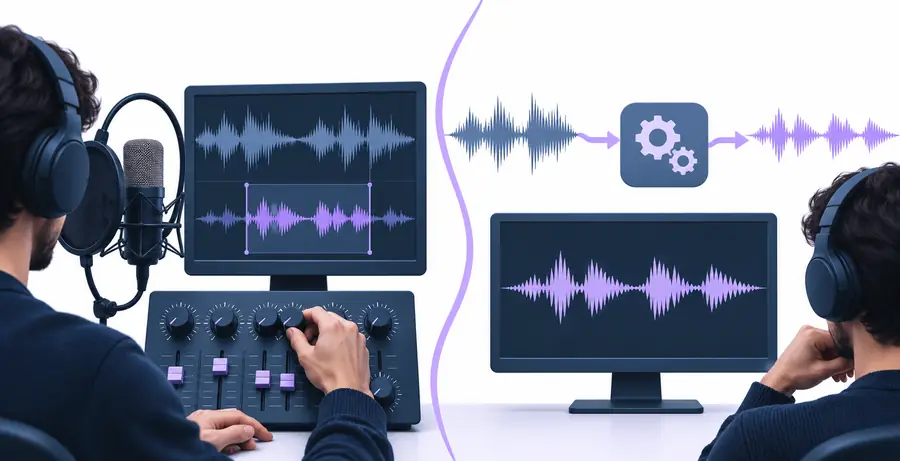
| Objectif principal |
Améliorer la clarté de la parole, l’équilibre et le confort d’écoute
|
Utiliser un traitement basé sur l’apprentissage pour apporter des modifications plus larges à l’audio
|
| Point de départ typique |
Une voix reconnaissable qui nécessite un nettoyage ou une finition
|
Une source difficile pour laquelle un nettoyage ordinaire peut ne pas suffire
|
| Ampleur des modifications |
Généralement plus limitée et plus facile à maintenir subtile
|
Potentiellement plus importante, selon l’outil et la source
|
| Contrôle |
Souvent plus facile à évaluer comme une suite de décisions audio familières
|
Peut s’appuyer davantage sur l’interprétation d’un modèle automatisé
|
| Naturel |
Convient bien lorsque la priorité est de préserver la voix du locuteur d’origine
|
Peut sembler convaincant, mais des réglages agressifs peuvent créer des artefacts synthétiques
|
| Meilleur premier test |
À essayer lorsque la parole est présente, mais masquée, terne ou irrégulière
|
À essayer lorsqu’une séparation, une reconstruction ou une intervention plus importante est nécessaire
|
| Risque principal |
Un nettoyage excessif peut supprimer une ambiance de pièce utile ou rendre la voix trop fine
|
Un traitement excessif peut modifier l’identité, le rythme, la texture ou les consonnes
|
| Question à examiner |
La même voix est-elle plus facile à suivre maintenant ?
|
Le résultat transformé correspond-il toujours au locuteur et au contexte ?
|