| Hauptzweck |
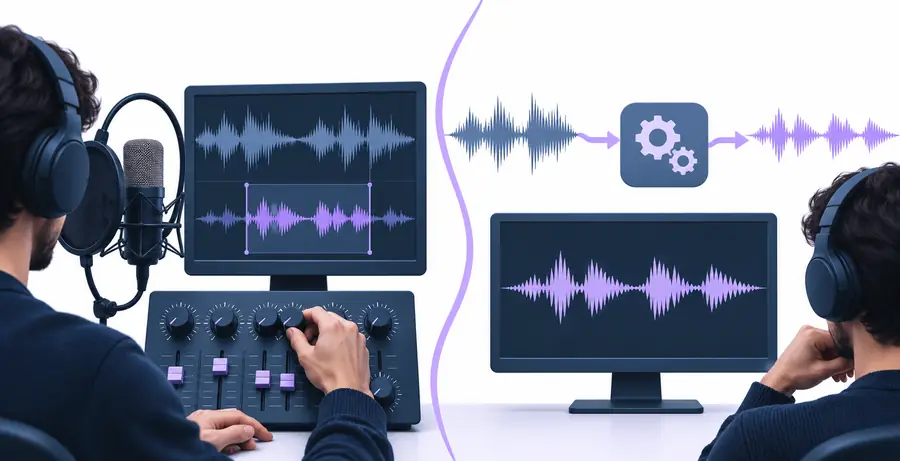
Sprachverständlichkeit, Ausgewogenheit und Hörkomfort verbessern
|
Gelernte Verarbeitung verwenden, um umfassendere Änderungen am Audio vorzunehmen
|
| Typischer Ausgangspunkt |
Eine wiedererkennbare Stimme, die Bereinigung oder Feinschliff benötigt
|
Eine schwierige Ausgangsaufnahme, bei der eine gewöhnliche Bereinigung möglicherweise nicht ausreicht
|
| Umfang der Veränderung |
Üblicherweise begrenzter und leichter dezent zu halten
|
Je nach Tool und Ausgangsaufnahme möglicherweise umfassender
|
| Kontrolle |
Oft leichter als Abfolge vertrauter Audiobearbeitungsentscheidungen zu beurteilen
|
Kann sich stärker auf die Interpretation eines automatisierten Modells stützen
|
| Natürlichkeit |
Gute Wahl, wenn die Erhaltung des ursprünglichen Sprechers Priorität hat
|
Kann überzeugend klingen, aber aggressive Einstellungen können synthetische Artefakte erzeugen
|
| Bester erster Test |
Probieren Sie es aus, wenn die Sprache vorhanden, aber verdeckt, dumpf oder ungleichmäßig ist
|
Probieren Sie es aus, wenn Trennung, Rekonstruktion oder ein stärkerer Eingriff erforderlich ist
|
| Hauptrisiko |
Eine übermäßige Bereinigung kann nützliche Raumanteile entfernen oder die Sprache dünn klingen lassen
|
Eine übermäßige Bearbeitung kann Identität, Timing, Klangtextur oder Konsonanten verändern
|
| Prüffrage |
Ist dieselbe Stimme jetzt leichter zu verstehen?
|
Passt das umgewandelte Ergebnis weiterhin zum Sprecher und zum Kontext?
|